Robots.txt og KI-trening: bør du blokkere KI på nettsiden din?
Google, OpenAI og flere vil støtte en felles innstilling i robots.txt som sier nei til KI-trening. Her er hvordan den virker, hva den ikke gjør med synligheten i Google og KI-søk, og om bedriften din bør bruke den.
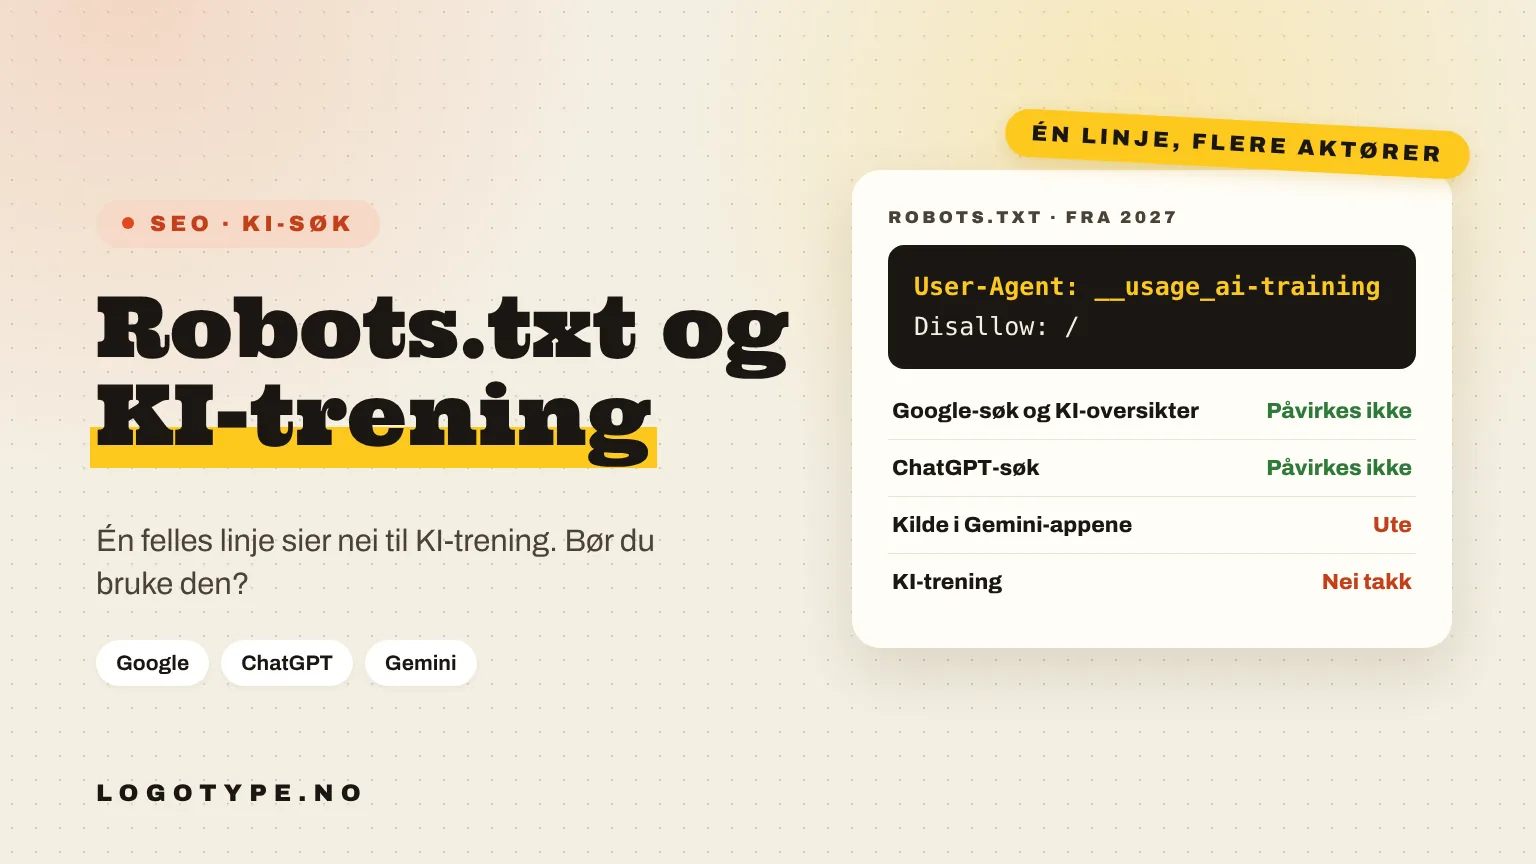
Fredag 30. oktober 2026 skrev Google at de skal støtte en felles innstilling for KI-trening i robots.txt. Med én linje skal du kunne si nei, eller ja, til at innholdet på nettsiden brukes til å trene KI-modeller, og flere KI-aktører skal lese den samme linjen. OpenAI har sagt at de vil gjøre det samme.
Det er et godt grep, men det kommer garantert spørsmål fra bedriftseiere: Bør jeg blokkere KI? Og forsvinner jeg fra Google eller ChatGPT hvis jeg gjør det? Her er svarene.
Hva er robots.txt?
Robots.txt er en liten tekstfil som ligger på dittdomene.no/robots.txt. Den forteller roboter som Googlebot hvilke deler av siden de kan besøke. Filen er en anmodning, ikke en lås: seriøse aktører følger den, men den stopper ingen som ikke vil.
Til nå har hver KI-aktør hatt sitt eget navn å skrive reglene for. Google har Google-Extended, OpenAI har GPTBot, og så videre. Vil du si nei til alle, må du vite om alle.
Hva er nytt?
Forslaget heter Machine-Readable Training Preference Signal og er et utkast i IETF, organisasjonen som lager internettstandarder. Det bygger på arbeidsgruppen AIPREF, som har jobbet fram en felles definisjon av KI-trening. Utkastet er skrevet av Kevin Kelley i Anthropic og ble publisert samme dag som Google gikk ut.
Ideen er enkel: i stedet for navnet på en bestemt robot skriver du et felles navn, __usage_ai-training, og bruker vanlige Disallow- og Allow-linjer:
User-Agent: __usage_ai-training
Disallow: /
Det betyr «ikke bruk innholdet mitt til KI-trening». Du kan også gjøre unntak for enkelte mapper, slik eksempelet i utkastet viser:
User-Agent: __usage_ai-training
Disallow: /
Allow: /presse/
Tre detaljer er verdt å merke seg:
- Det gjelder trening, ikke besøk. Linjen sier hva du ønsker at innholdet brukes til. Den bestemmer ikke hvilke roboter som får hente sidene.
- Stjernen teller ikke. En regel for
User-Agent: *blir ikke tolket som et svar på KI-trening. Står ikke__usage_ai-trainingi filen, har du ikke sagt noe. - Det virker ikke bakover. Det som allerede er brukt til trening, blir ikke fjernet.
Når virker det?
Ikke ennå. Google skriver at de tar sikte på å støtte innstillingen i 2027, og dokumentasjonen deres sier tidlig 2027. OpenAI sier de vil følge signalet i løpet av de kommende månedene. Utkastet er heller ikke en ferdig standard, så detaljer kan endre seg.
Begge skriver også at de eksisterende reglene fortsetter å virke. Den felles linjen gir et bredt ja eller nei, og de egne navnene lar deg gjøre unntak for én aktør.
Hvordan påvirker det synligheten i Google?
Det korte svaret: ikke i vanlig Google-søk. Når siden din sier nei til KI-trening med den nye linjen, og ikke nevner Google-Extended, skal Google tolke det som et nei til Google-Extended. Og om Google-Extended skriver Google at det ikke påvirker om siden tas med i Google-søk, og at det ikke brukes som rangeringssignal.
Det samme gjelder KI-oversikter og AI Mode i Google-søk. Google skriver at KI er bygget inn i søket, og at det er reglene for Googlebot som bestemmer om sidene kan hentes til søk. Vil du begrense hva som vises fra sidene dine der, er det nosnippet, max-snippet og noindex som gjelder, og de virker på hele søket, ikke bare KI-delen.
Men det finnes én hake. Google-Extended styrer ikke bare trening av Gemini-modellene, men også om innholdet ditt kan brukes som kilde i svar i Gemini-appene. Google skriver at sider som eksplisitt tillater Google-Extended, kan vises i svar og få klikk derfra. Sier du nei til KI-trening med den felles linjen, sier du altså også nei til å bli brukt som kilde i Gemini, med mindre du tillater Google-Extended for seg.
Og i ChatGPT?
OpenAI skiller allerede mellom to roboter. GPTBot henter innhold som kan brukes til å trene modellene. OAI-SearchBot henter innhold til søket i ChatGPT. OpenAI skriver at innstillingene er uavhengige av hverandre, og at sider som stenger ute OAI-SearchBot, ikke vises i søkesvarene i ChatGPT.
Den nye felles linjen handler om trening, altså det GPTBot gjør. Du kan si nei til trening og fortsatt bli funnet i ChatGPT-søk.
Bør bedriften din blokkere KI-trening?
Det kommer an på hva innholdet på nettsiden er for noe.
For de fleste: la være. Er du rørlegger, regnskapskontor, frisør eller nettbutikk, er nettsiden markedsføring. Du vil at flest mulig skal vite hvem du er og hva du gjør, også når noen spør en KI-assistent om råd uten å søke. En modell kan bare nevne det den kjenner til. Ingen kan si nøyaktig hvor mye det betyr, men det er vanskelig å se hva du tjener på å si nei. Du mister heller ikke noe på å vente og se hvordan dette utvikler seg.
Vurder å blokkere hvis innholdet er produktet. Selger du kurs, skriver fagartikler folk betaler for, har egne bilder eller oppskrifter som er grunnen til at folk kommer til deg, er det et rimelig valg å si nei. Da kan du også blokkere bare de delene som er verdifulle, og la resten være åpent.
Selv tillater jeg alt på logotype.no. Jeg vil at både Google og KI-assistentene skal vite hva jeg driver med.
Tre oppsett du kan bruke
1. Tillat alt. Gjør ingenting. Uten en regel for KI-trening har du ikke sagt nei.
User-agent: *
Allow: /

Sitemap: https://www.dittdomene.no/sitemap.xml
2. Nei til KI-trening, men synlig i søk. Legg til den felles linjen og de egne navnene som virker i dag. Søkerobotene til Google og OpenAI blir ikke berørt.
User-agent: *
Allow: /

User-Agent: __usage_ai-training
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: GPTBot
Disallow: /

Sitemap: https://www.dittdomene.no/sitemap.xml
Husk at du da også sier nei til å bli brukt som kilde i Gemini-appene. Vil du være med der, må du tillate Google-Extended, og da sier du samtidig ja til trening hos Google.
3. Beskytt bare det som er verdifullt. Steng for eksempel kursmappen, og la resten være åpent.
User-Agent: __usage_ai-training
Disallow: /kurs/
Vanlige feil som koster synlighet
- Å blokkere Googlebot for å stoppe KI. Da forsvinner du fra Google, ikke bare fra KI. Googlebot er søkeroboten.
- En glemt
Disallow: /under stjernen. Den stenger alle ute. Det skjer oftere enn man tror, gjerne etter at en testside ble satt i drift. - Blokkering hos webhotellet eller CDN-en. Mange tjenester har en bryter for å stoppe «KI-roboter» som også kan treffe søkeroboter. Google minner om at sidene må kunne hentes både i robots.txt og hos den som leverer sidene.
- Å tro at
noindexeller robots.txt bare treffer KI. Begge virker på hele Google-søket.
Lurer du på hvordan det står til hos deg, viser den gratis nettsjekken blant annet om siden har en robots.txt, og om den ber søkemotorene holde seg unna.
Få det gjort skikkelig, én gang
Robots.txt er en liten fil, men en feil i den kan koste mer enn alt annet SEO-arbeid til sammen. Når jeg gjør en SEO-optimalisering til fastpris, går jeg gjennom robots.txt, indeksering og blokkeringer hos webhotellet, sammen med struktur, landingssider, teknisk SEO og strukturerte data. Du får et bevisst valg om KI-trening, og en side som er lett å finne både i Google og i KI-søk.
Det koster fra 17 900 kr eks. mva., uten abonnement og uten binding. Lurer du på hva andre tar, har jeg samlet hva SEO koster i Norge, og om du trenger det, står i når trenger nettsiden din et SEO-push. Start gjerne med en gratis SEO-analyse.
Kilder
- Google Search Central: Supporting a shared AI training control for websites
- IETF: Machine-Readable Training Preference Signal (utkast)
- Google: Google-Extended og Googles vanlige crawlere
- Google: AI features and your website
- OpenAI: Making it easier for websites to express AI training preferences
- OpenAI: Overview of OpenAI Crawlers